Une liste de prix PDF peut devenir des fiches produit prêtes à vendre
Découvrez comment lire une liste de prix PDF par blocs, associer ses données aux champs produit et synchroniser WooCommerce par SKU, sans doublons ni GTIN inventés.
Du PDF à des fiches produit réellement vendables en ligne
Une liste de prix PDF devient une série de fiches produit lorsque chaque ligne est associée à des champs de boutique tels que le titre, le SKU, le prix, la devise, le GTIN et l’image. Le fichier est lu par blocs, et non comme une simple capture d’écran. Des colonnes parfaitement alignées sur papier peuvent fusionner lors de l’extraction, les unités peuvent rester dans les en-têtes et les notes de bas de page n’apparaissent jamais dans la description si vous ne les copiez pas volontairement. Une fiche n’est complète qu’à la mesure des cellules conservées, des codes vérifiés et des photos associées.
Lorsqu’un robot d’exploration ou un lecteur de flux shopping ouvre un produit WooCommerce, il recherche des champs nommés : id, title, description, link, image_link, price, availability, brand et gtin, ou identifier_exists lorsque le code fabricant est absent. Un PDF présent dans une boîte de réception n’expose aucun de ces champs. Merchant Center › Produits › Flux ne peut rien importer tant que la ligne n’est pas devenue une fiche produit. Le changement est concret : le tableau cesse d’être une image de prix et devient une donnée que la boutique, le flux et un assistant peuvent exploiter. C’est aussi la raison pour laquelle Google lit les données produit avant vos textes sur la page publique.
Pourquoi une liste de prix PDF ne met jamais à jour le catalogue en ligne toute seule
Un PDF n’envoie pas les titres, les prix ou les stocks dans WooCommerce : chaque ligne doit devenir une fiche produit avant que la boutique ou un flux puisse l’utiliser.
Les fournisseurs envoient encore des listes saisonnières prêtes à imprimer, car le PDF conserve la mise en page, les logos et les mentions légales. C’est pratique sur papier, mais peu exploitable comme source de catalogue. WooCommerce › Produits › Tous les produits attend un SKU, un nom, un prix normal et un statut de stock. Aucun de ces noms n’existe dans le PDF tant qu’un lecteur n’a pas séparé les lignes d’en-tête des lignes de données et attribué chaque colonne. Tant que cette association n’est pas confirmée, le catalogue en ligne vieillit tandis que le PDF du dossier partagé continue d’être considéré comme la vraie liste.
Le même fichier échoue aussi comme flux shopping. Une ligne de flux a besoin de id, title, description, link, image_link, price avec une devise ISO, availability, brand et gtin. Copier le PDF dans la description d’un produit transforme tout le tableau en un bloc de texte. Le robot voit alors un paragraphe, pas un prix. Si vous avez ensuite besoin d’un flux produit WooCommerce pour ChatGPT, ce bloc n’est toujours pas un flux. Commencez par les champs, pas par une capture de la liste.
Pour les personnes qui ont peu de temps à consacrer au catalogue quotidienLes personnes qui passent déjà leur matinée à répondre aux questions sur les stocks n’ont pas forcément le temps de ressaisir quarante lignes après chaque PDF fournisseur. La méthode utile consiste à lire le nouveau fichier par blocs, à confirmer une fois l’association des colonnes, puis à mettre à jour les produits par SKU afin de modifier les produits existants plutôt que de les cloner. Les copier-coller manuels entre PDF, tableur et WooCommerce sont souvent à l’origine de la perte des unités, des notes et des codes-barres.
Un atelier qui vend des céramiques et gère environ quarante SKUUn atelier qui vend des céramiques et gère environ quarante SKU reçoit souvent une liste d’une page : code, nom de l’émail, diamètre, conditionnement, prix. Ces quarante lignes semblent peu nombreuses, mais elles cachent les mêmes pièges qu’un import de 400 lignes : un diamètre placé dans l’en-tête, une quantité par paquet collée au prix ou une note sur l’utilisation au lave-vaisselle qui n’arrive jamais dans la description. Quarante fiches suffisent pour qu’une devise erronée ou un SKU dupliqué soit repéré dans la boutique le jour même.
Pour les personnes qui actualisent un PDF fournisseur à chaque saisonLes personnes qui actualisent un PDF fournisseur à chaque saison ont besoin d’une association reproductible, pas d’une ressaisie héroïque. Les prix changent, les couleurs reçoivent un nouveau suffixe et les codes arrêtés disparaissent. La clé durable est le SKU déjà présent dans WooCommerce. Si le nouveau PDF est importé comme une nouvelle liste sans cette clé, la boutique accumule des doublons silencieux et les anciennes URL conservent l’ancien prix.
Ce qu’une lecture PDF par blocs conserve réellement, et ce qu’elle perd
Une lecture par blocs conserve les cellules auxquelles elle peut attribuer un nom et laisse de côté la mise en page qui ne correspond pas à un champ, notamment les colonnes fusionnées, les unités présentes uniquement dans l’en-tête et les notes de bas de page.
Une liste de prix PDF n’est pas une seule image de catalogue. C’est un empilement de blocs : en-têtes répétés, corps de tableau, pied de page contenant des mentions légales et parfois groupe de photos. Un lecteur travaillant par blocs repère d’abord le tableau, puis la ligne d’en-tête et enfin chaque ligne de données. Si le fichier possède une véritable couche de texte, ces cellules sont des caractères. S’il s’agit d’un scan imprimé, le lecteur passe par la reconnaissance optique et les cellules fusionnées deviennent plus probables.
Un flux ACP est un flux produit structuré de façon à ce qu’un assistant puisse utiliser les données de la boutique, identité, prix, disponibilité et lien, plutôt que d’extraire un paragraphe. Il a besoin des mêmes champs essentiels que tout autre flux produit. L’extraction du PDF n’est que la première étape vers cette fiche. Les pertes typiques sont les suivantes :
- Colonnes fusionnées : le SKU et le titre arrivent dans une seule cellule, si bien que le nom devient « CR-204 Bowl stoneware ».
- Unité de mesure dans l’en-tête uniquement : « Prix / paquet de 4 » ne se recopie pas sur la ligne et le prix de la fiche ressemble à un prix à l’unité.
- Notes de bas de page : un astérisque renvoie à « TVA exclue » ou « ne convient pas au micro-ondes » en bas de page, mais cette phrase n’entre pas dans la description.
- En-têtes répétés traités comme des produits supplémentaires, avec les titres de colonnes transformés en SKU.
- Tableaux sur plusieurs pages qui recommencent la numérotation, donnant l’impression que la page 2 est un nouveau catalogue.
- Photos intégrées placées à côté du tableau, mais non associées à un SKU.
- Numéros de codes-barres coupés par un retour à la ligne, ce qui peut invalider le chiffre de contrôle avant même la saisie de la fiche.
Ces pertes expliquent pourquoi un « import PDF » qui déverse uniquement du texte dans l’éditeur de contenu WooCommerce ne constitue pas un catalogage. C’est un collage. Les champs nommés doivent être confirmés. La même rigueur s’applique à une fiche technique produit sans inventer de spécifications : si le PDF ne mentionne pas un matériau, la fiche ne doit pas en inventer un.
Une ligne de catalogue qui vit encore uniquement dans un PDF n’est pas un produit. C’est l’image d’un tableau qu’aucun lecteur de flux ne peut interpréter.
Comment associer les cellules extraites aux champs produit
Chaque colonne utile du PDF est associée à un champ de boutique, et tout élément auquel aucun nom ne peut être donné reste hors de la fiche jusqu’à confirmation.
Une fois le tableau détecté, le travail consiste à associer les colonnes, et non à réécrire le document. Observez les libellés imprimés par le fournisseur et attribuez-les aux champs déjà compris par une boutique et un flux. Une association pratique pour une liste de prix ressemble à ceci :
- Code, art., réf. ou SKU correspond à id dans le flux et au SKU WooCommerce.
- Description ou nom de l’article correspond à title ; les notes restantes vont dans description, pas dans le titre.
- Prix correspond à price ; le symbole monétaire ou le code ISO correspond à currency et ne doit jamais être intégré au nombre.
- Stock ou « disponible » correspond à availability, en stock, rupture, précommande, lorsque le PDF le précise réellement.
- Marque correspond à brand uniquement lorsque la cellule nomme une marque, et non une gamme de produits.
- EAN, UPC, ISBN ou GTIN correspond à gtin uniquement après validation du chiffre de contrôle ; sinon identifier_exists est le signal honnête.
- Couleur, taille ou conditionnement correspond à des attributs, dans WooCommerce › Produits › Attributs, et non à un second titre.
Ce qui ne doit pas être automatique, c’est l’invention. Si le PDF ne précise jamais le poids, la fiche n’en reçoit pas. Si l’émail est « bleu » et non « sous-émail cobalt », le titre reste « bleu ». Une réécriture contrôlée par les faits peut harmoniser la casse, supprimer du HTML résiduel et remplir les champs de spécification vides à partir du fichier du marchand. Elle ne remplace pas un fait manquant par une supposition trouvée sur le Web. Lorsque deux tailles partagent un titre, leur regroupement comme variantes avec item_group_id ne se fait qu’après confirmation, jamais en silence.
Comment associer les images intégrées du PDF aux SKU
Les photos emprisonnées dans le PDF ne sont utiles que lorsqu’elles sont extraites comme fichiers et associées au même SKU que la ligne.
De nombreux catalogues fournisseurs placent une miniature dans la première colonne ou une image principale au-dessus d’un groupe de SKU. Un lecteur par blocs peut extraire ces images intégrées du PDF et les enregistrer comme fichiers produit. L’association est une étape distincte. Une photo placée à côté d’une ligne peut être associée par sa position. En revanche, une photo située au-dessus de trois bols ne peut pas être attribuée aux trois sans confirmation, car le champ image_link d’un flux est généralement censé renvoyer vers une image principale par fiche.
Lorsque le PDF ne contient aucune photo exploitable, la fiche a tout de même besoin d’une image avant d’être considérée comme complète par les surfaces shopping. Les images plus petites qu’environ 500 × 500 pixels semblent moins souvent acceptées par les surfaces shopping, même si aucun seuil unique et vérifiable n’est publié. Les options qui restent honnêtes sont les suivantes : réutiliser un recadrage du PDF s’il est suffisamment net, importer une photo de produit que vous possédez, rechercher une image sur le Web et confirmer les droits, ou générer une image illustrative en la signalant comme générée conformément à l’article 50 de l’AI Act. Les images partagées par de nombreux SKU doivent être signalées, car cinq bols portant la même miniature semblent identiques dans Merchant Center › Produits › Flux.
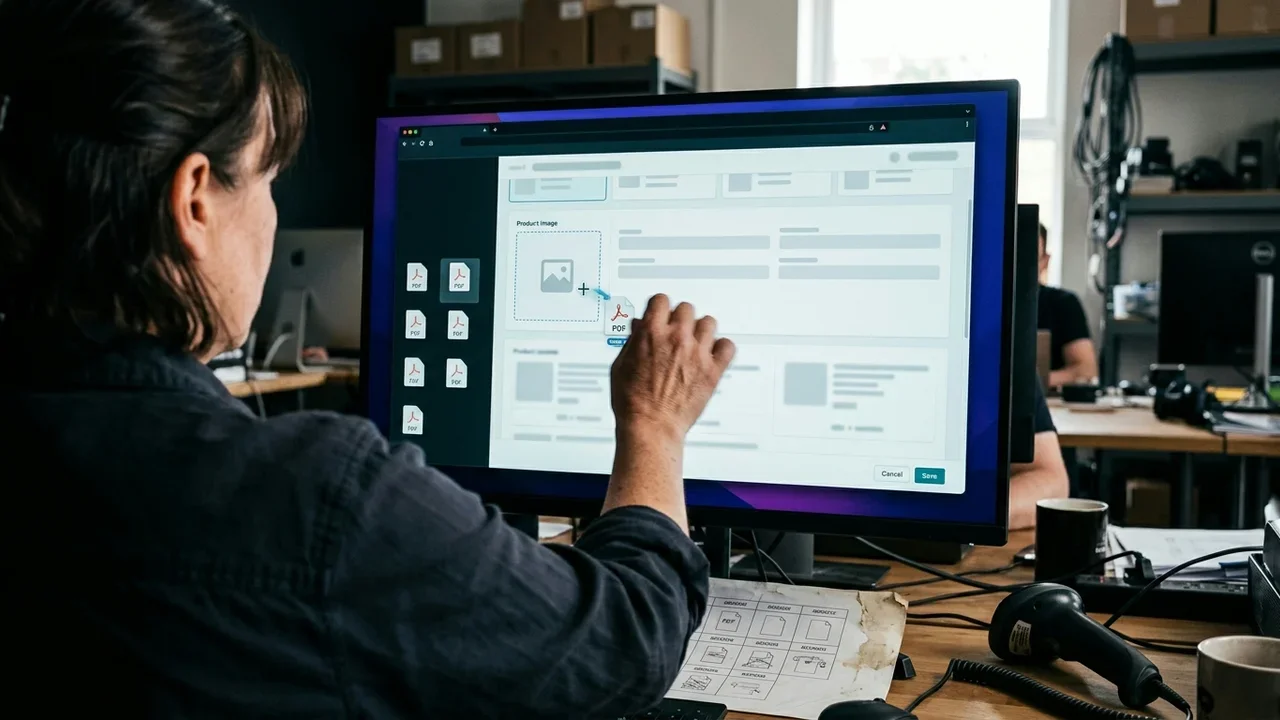
Comment traiter les GTIN, les prix et les devises
Les codes-barres et les prix sont copiés depuis le PDF du marchand et validés comme des nombres ; ils ne sont jamais récupérés sur le Web.
Un GTIN, EAN-13, UPC-A, GTIN-14 ou ISBN, est une suite de chiffres qui se termine par un chiffre de contrôle GS1. Celui-ci est calculé à partir des chiffres précédents. Si le dernier chiffre ne correspond pas au calcul, le code n’est pas un GTIN valide et ne doit pas être inscrit dans la fiche. Le numéro est lu dans la cellule du PDF, sur un code-barres imprimé sur la page ou sur une photo de produit déjà détenue par le marchand. Il n’est pas recherché en ligne, car une recherche Web peut associer au SKU le code d’un autre produit.
Les prix nécessitent la même séparation. Une cellule indiquant « 12,50 €* » ne constitue pas un prix de flux. Le nombre est 12,50, la devise est EUR et l’astérisque renvoie à une note pouvant indiquer « TVA exclue » ou « par paquet de 4 ». Les listes européennes utilisent souvent la virgule comme séparateur décimal ; les flux attendent un point. Ne laissez pas le symbole dans le nombre. Ne convertissez pas la devise, sauf si le PDF indique que la liste est exprimée dans cette devise. La disponibilité reste vide tant que le fichier ne la précise pas ; un ancien PDF saisonnier ne prouve pas que l’article est encore en stock aujourd’hui.
Un GTIN est lu dans le PDF, la photo de produit ou la colonne CSV du marchand et doit passer le contrôle du chiffre GS1. Il n’est jamais recherché sur le Web.
Un parcours numéroté du fichier à la fiche WooCommerce
Le parcours fiable consiste à extraire par blocs, associer les colonnes, confirmer les images et les codes, puis synchroniser par SKU afin de mettre à jour la boutique sans créer de doublons.
Utilisez cette séquence sur une véritable liste de prix, qu’il s’agisse d’une liste de céramiques d’une page ou d’un catalogue fournisseur de plusieurs pages. L’objectif est d’obtenir une fiche que vous pourriez intégrer dans WooCommerce › Produits sans nouvelle enquête.
- Conservez un PDF numérique avec une couche de texte lorsque le fournisseur peut en envoyer un. Une photo d’un document imprimé impose la reconnaissance optique et augmente les risques de cellules fusionnées.
- Importez le PDF afin que le fichier soit lu par blocs : en-têtes, corps du tableau, pieds de page et images intégrées.
- Repérez la ligne d’en-tête. Si « Prix € / 4 pièces » est un en-tête, enregistrez conditionnement = 4 et currency = EUR comme signification de colonne, pas comme titre produit.
- Associez les colonnes à id (SKU), title, description, price, availability, brand, gtin et aux attributs comme la taille ou la couleur.
- Copiez dans la description les notes de bas de page lorsqu’elles constituent des faits produit, comme « compatible lave-vaisselle » ou « TVA exclue ». Laissez les mentions juridiques hors du titre.
- Exécutez le contrôle du chiffre GS1 sur chaque code-barres. Rejetez les échecs. Si le fabricant ne possède aucun GTIN, utilisez identifier_exists au lieu d’inventer un code.
- Associez les images extraites aux SKU. Confirmez les photos de groupe. Envisagez de remplacer les fichiers de très petite taille, car les images plus petites semblent moins souvent acceptées par les surfaces shopping.
- Examinez une ligne complète comme fiche produit, à partir de l’exemple avant-après ci-dessous, avant d’accepter le lot.
- Synchronisez avec WooCommerce par SKU à l’aide de l’extension officielle afin que les produits existants soient mis à jour et que les nouveaux SKU ne créent qu’une fiche. Ne créez jamais un second produit simplement parce que le titre a changé.
- Lorsque les fiches sont complètes, exportez uniquement les lignes prêtes vers Merchant Center › Produits › Flux et conservez les mêmes champs pour un flux produit ChatGPT.
Avant, tel qu’imprimé sur une ligne du PDF : CR-204 | Bol en grès, Ø 18 cm, émail bleu* | 4 pièces | 12,50 €. Pied de page : * compatible lave-vaisselle, incompatible micro-ondes. Aucun code-barres sur la ligne. Une miniature d’un bol bleu se trouve dans la marge gauche.
Après, la fiche à enregistrer :
- id / SKU : CR-204
- titre : Bol en grès, émail bleu, 18 cm
- description : Compatible lave-vaisselle. Ne convient pas au micro-ondes. Vendu par paquet de 4.
- prix : 12,50 EUR, avec séparation du nombre et de la devise
- disponibilité : vide, sauf si le PDF indique le stock
- marque : uniquement si la liste en nomme une
- gtin : vide ; identifier_exists est défini car aucun code fabricant n’apparaît sur la page
- image_link : miniature extraite si elle est nette et de bonne résolution ; sinon photo de produit confirmée
- attribut conditionnement : 4 ; attribut diamètre : 18 cm
Cet état final est l’objectif de la conversion d’un PDF en fiches produit : des champs nommés, des faits confirmés et aucun SKU supplémentaire.
Erreurs courantes
La plupart des imports PDF qui échouent ne sont pas des « erreurs d’IA » : ce sont des cellules qui contiennent encore deux faits, un chiffre de contrôle incorrect ou un SKU déjà utilisé par la boutique.
SKU non valide ou dupliquéLe message de la boutique est « SKU non valide ou dupliqué ». Il apparaît lorsque WooCommerce possède déjà ce SKU et que l’import tente de créer un second produit au lieu de mettre à jour le premier. Cela arrive notamment après l’envoi d’un PDF saisonnier utilisant les mêmes codes avec de nouveaux prix. Résolvez le problème en recherchant le SKU, en écrivant le nouveau prix et le nouveau titre sur le produit existant et en conservant le permalien. La synchronisation bidirectionnelle par SKU est la solution ; une création vierge ne l’est pas.
Valeur manquante [gtin]Merchant Center signale « Valeur manquante [gtin] » lorsque la ligne du flux ne contient ni GTIN ni indicateur identifier_exists explicite. Cela se produit lorsque le code-barres du PDF a été ignoré, coupé par un retour à la ligne ou rejeté après le contrôle du chiffre, puis laissé vide. Pour résoudre le problème, lisez les chiffres dans le PDF ou la photo du marchand, validez le chiffre de contrôle GS1 et renseignez gtin uniquement si le contrôle est réussi. Si le fabricant n’a pas de GTIN, déclarez cette absence. Ne cherchez pas un code de remplacement sur le Web.
Le prix doit être un nombreL’éditeur ou le validateur du flux renvoie « Le prix doit être un nombre », ou signale une incohérence de devise lorsque le symbole apparaît sans code ISO. Cela se produit lorsque la cellule contient encore « 12,50 €* », « à partir de 12 » ou « 12,50 / 4 pièces ». Séparez le montant, la devise, le conditionnement et la note. Utilisez un point décimal dans le flux, conservez EUR comme code de devise et placez « paquet de 4 » dans un attribut ou dans la description.
Impossible de détecter un tableau sur cette pageLe lecteur renvoie « Impossible de détecter un tableau sur cette page » lorsque le PDF est une photographie, un catalogue très graphique dont les prix sont traités comme des éléments visuels ou une page composée uniquement de notes et de photos. Il n’existe alors ni couche de texte ni grille exploitable. Demandez au fournisseur la liste numérique, fournissez un CSV en complément du PDF ou marquez manuellement les blocs produit afin de pouvoir associer les images et les légendes voisines. Ne saisissez pas un faux tableau dans la description simplement pour faire fonctionner l’import.
Comment Katapic transforme le même PDF en fiches que vous confirmez
Katapic lit les listes de prix et les catalogues par blocs, extrait les images intégrées et synchronise WooCommerce par SKU afin que vous confirmiez les faits au lieu de les ressaisir.
L’import PDF est conçu pour ce type de fichier : les listes et catalogues sont lus par blocs, les images intégrées sont extraites et les photos sont associées aux produits pour que vous les confirmiez. Le même espace accepte également une photo, une photo, une fiche, et un CSV. Rien dans le catalogue n’est modifié avant votre validation. Le premier scan d’un catalogue WooCommerce public peut être effectué sans compte, en lecture seule, sur un maximum de 100 produits, avec des scores distincts pour la recherche classique et la préparation aux assistants, ainsi qu’un axe de complétude pour les champs manquants ou incorrects.
Les GTIN suivent la même règle que dans le reste de cet article : ils sont lus dans votre PDF, votre photo de produit ou votre colonne CSV et doivent passer le contrôle du chiffre GS1. Ils ne sont jamais recherchés sur le Web. La réécriture est vérifiée par rapport aux faits ; les marques, certifications et éléments historiques ne sont pas inventés, et une mesure trouvée sur le Web qui contredit votre titre n’est pas intégrée. Une fiche réécrite coûte 1 crédit et une image coûte 1 crédit. Il n’y a pas d’abonnement. Les crédits n’expirent pas. Les produits sans photo peuvent utiliser un recadrage du PDF, un import manuel, une image Web après confirmation des droits ou une illustration générée signalée conformément à l’article 50 de l’AI Act.
La synchronisation avec WooCommerce est bidirectionnelle par SKU et ne crée pas de doublons. L’extension officielle se trouve sur WordPress.org. La préparation des canaux couvre ensuite Google Shopping, le flux ChatGPT, Meta, le PDF, la boutique et les réponses des assistants. Si vous avez besoin d’un catalogue imprimé après la création des fiches, Catalogue Studio en met un en page avec 30 modèles. Le parcours de travail à partir d’un fichier fournisseur est l’import Katapic, une association confirmée et la mise à jour des SKU que vous vendez déjà. Pour aller dans l’autre sens, un catalogue PDF mis en page peut être généré à partir des mêmes fiches.
FAQ
Comment importer une liste de prix PDF dans WooCommerce ?Lisez le PDF par blocs de tableau, associez les colonnes au SKU, au titre, à la description, au prix, à la devise et aux attributs, puis synchronisez par SKU afin de mettre à jour les produits existants. Ne collez pas la page entière dans l’éditeur produit. Confirmez les GTIN avec le chiffre de contrôle, associez les images intégrées et vérifiez ensuite un échantillon dans WooCommerce › Produits. Cette séquence limite les doublons lorsque le fournisseur envoie la liste de la saison suivante.
Quelles données produit peut-on extraire d’un catalogue PDF ?Vous pouvez généralement extraire le SKU, le titre, les notes supplémentaires, le prix, la devise, le conditionnement ou la taille, la marque lorsqu’elle est nommée, les codes-barres qui passent le contrôle du chiffre GS1 et les photos intégrées. Les unités présentes uniquement dans l’en-tête, les cellules fusionnées et les notes de bas de page ne sont pas des champs tant qu’elles n’ont pas été séparées. Les faits que le fichier ne mentionne pas, comme le poids ou le matériau, restent vides. L’extraction associe les données à id, title, description, price, availability, brand, gtin et image_link ; elle ne réécrit pas entièrement le catalogue.
Le catalogage à partir d’un PDF peut-il être automatique sans inventer de spécifications ?La détection des colonnes et l’extraction des images peuvent être automatiques. En revanche, il est impossible d’écrire un matériau, une certification ou un GTIN que le fichier ne contient pas. Le processus honnête remplit automatiquement les champs depuis le PDF, signale les échecs du chiffre de contrôle et attend une confirmation pour les variantes et la catégorie Google. Si une mesure trouvée ailleurs contredit le titre du marchand, la valeur du marchand l’emporte. Une automatisation qui invente une spécification produit une fiche difficile à défendre lors de l’examen d’un flux.
Comment un import de catalogue PDF fonctionne-t-il avec les SKU WooCommerce existants ?Le SKU du PDF est la clé de rapprochement. Lorsqu’il correspond à un produit déjà présent dans la boutique, l’import doit mettre à jour le prix, le titre et les images de ce produit et conserver son URL. Lorsqu’il est nouveau, un seul produit est créé. Le rapprochement sur le titre plutôt que sur le SKU crée des doublons après un changement de nom. La synchronisation bidirectionnelle par SKU sert de protection, y compris lors de l’export ultérieur d’un flux shopping à partir des mêmes fiches.
Que deviennent les codes-barres et les GTIN trouvés dans un PDF ?Les chiffres imprimés dans une cellule ou représentés sous forme de code-barres sont copiés, puis testés avec le chiffre de contrôle GS1. En cas de réussite, gtin est renseigné. En cas d’échec, le champ reste vide et ne doit pas être « corrigé » avec un numéro trouvé sur un moteur de recherche. Si le fabricant n’a jamais attribué de GTIN, utilisez identifier_exists au lieu de deviner. Cela évite que Merchant Center enregistre un code appartenant à un autre article et maintient la cohérence des flux destinés aux assistants avec le produit présent dans votre entrepôt.
Pourquoi les unités et les notes de bas de page disparaissent-elles lorsque je copie une liste de prix ?Les unités se trouvent souvent uniquement dans l’en-tête, « prix par paquet de 4 », tandis que les notes figurent en bas de page. Une copie limitée à la ligne ne les voit pas. La fiche affiche alors un prix à l’unité qui est en réalité un prix par paquet, ou elle omet « TVA exclue » et « ne convient pas au micro-ondes ». Lors de l’association, enregistrez l’unité de l’en-tête comme attribut et copiez les faits des notes dans la description. Sans cette séparation, chaque flux en aval répète l’erreur.
Dois-je générer un nouveau catalogue PDF après avoir nettoyé les fiches ?Une fois les SKU, les prix et les photos enregistrés comme fiches produit, un catalogue PDF paginé devient un résultat dérivé, et non la source de référence. Générez-le à partir des données de la boutique afin d’éviter les écarts entre l’imprimé et l’en ligne. Conservez le PDF reçu du fournisseur comme preuve des faits d’origine. Le catalogue en ligne, le flux shopping et tout flux destiné à un assistant doivent lire les mêmes champs que ceux confirmés après l’import, et non la mise en page du fichier de la saison précédente.
Pour aller plus loin
Questions fréquentes
- Comment importer une liste de prix PDF dans WooCommerce ?
- Lisez le PDF par blocs de tableau, associez les colonnes au SKU, au titre, à la description, au prix, à la devise et aux attributs, puis synchronisez par SKU afin de mettre à jour les produits existants. Ne collez pas la page entière dans l’éditeur produit. Confirmez les GTIN avec le chiffre de contrôle, associez les images intégrées et vérifiez un échantillon dans WooCommerce › Produits avant d’accepter le lot.
- Quelles données produit peut-on extraire d’un catalogue PDF ?
- Vous pouvez généralement extraire le SKU, le titre, les notes supplémentaires, le prix, la devise, le conditionnement ou la taille, la marque lorsqu’elle est nommée, les codes-barres qui passent le contrôle du chiffre GS1 et les photos intégrées. Les unités présentes uniquement dans l’en-tête, les cellules fusionnées et les notes de bas de page ne sont pas des champs tant qu’elles n’ont pas été séparées. Les faits que le fichier ne mentionne pas restent vides au lieu d’être inventés.
- Le catalogage à partir d’un PDF peut-il être automatique sans inventer de spécifications ?
- La détection des colonnes et l’extraction des images peuvent être automatiques. En revanche, il est impossible d’écrire un matériau, une certification ou un GTIN que le fichier ne contient pas. Remplissez les champs depuis le PDF, rejetez les échecs du chiffre de contrôle et confirmez les variantes. Si une autre source contredit le titre du marchand, la valeur du marchand l’emporte et l’affirmation supplémentaire reste exclue.
- Comment un import de catalogue PDF fonctionne-t-il avec les SKU WooCommerce existants ?
- Le SKU du PDF est la clé de rapprochement. Une correspondance met à jour le prix, le titre et les images du produit existant et conserve son URL. Un nouveau SKU crée un seul produit. Le rapprochement sur le titre plutôt que sur le SKU crée des doublons après un changement de nom. La synchronisation bidirectionnelle par SKU protège les flux shopping et les flux destinés aux assistants.
- Que deviennent les codes-barres et les GTIN trouvés dans un PDF ?
- Les chiffres imprimés dans une cellule ou représentés sous forme de code-barres sont copiés, puis testés avec le chiffre de contrôle GS1. En cas de réussite, gtin est renseigné. En cas d’échec, le champ reste vide. Ne le remplacez pas avec un numéro trouvé sur un moteur de recherche. Si le fabricant n’a jamais attribué de GTIN, utilisez identifier_exists au lieu de deviner un code qui pourrait appartenir à un autre article.
- Pourquoi les unités et les notes de bas de page disparaissent-elles lorsque je copie une liste de prix ?
- Les unités se trouvent souvent uniquement dans l’en-tête et les notes uniquement en bas de page. Une copie limitée à la ligne ne les voit pas. La fiche affiche alors un prix par paquet comme un prix à l’unité ou perd des consignes de sécurité. Enregistrez l’unité de l’en-tête comme attribut et copiez les faits des notes dans la description lors de l’association.
- Dois-je générer un nouveau catalogue PDF après avoir nettoyé les fiches ?
- Une fois les SKU, les prix et les photos enregistrés comme fiches produit, un catalogue PDF paginé devient un résultat dérivé et non la source de référence. Générez-le à partir des données de la boutique pour éviter les écarts entre les canaux. Conservez le PDF fournisseur comme preuve des faits d’origine et laissez le catalogue en ligne et les flux lire les champs confirmés après l’import.